Топ-5 продвинутых методов анализа: что делает каждый и зачем он нужен
XGBoost, генетические алгоритмы, обучение с подкреплением, временные ряды и байесовские модели — без академического тумана и без обещаний выигрыша.
Коротко о чём статья
В разделе продвинутого анализа собраны методы, которые в других областях решают серьёзные задачи: предсказывают отток клиентов, оптимизируют логистику, обыгрывают людей в го.
Ниже — что каждый из них делает, зачем он здесь и где у него граница. Договоримся сразу: ни один не повышает шанс выигрыша. В честной лотерее это невозможно в принципе. Но каждый показывает что-то своё о структуре данных, и в этом их польза.
1. XGBoost с объяснением решений
Градиентный бустинг — рабочая лошадка прикладного машинного обучения. Строит сотни маленьких деревьев решений, где каждое следующее исправляет ошибки предыдущих. На табличных данных это один из самых сильных методов вообще.
Главная ценность здесь не в самой модели, а в надстройке SHAP: она раскладывает каждое решение на вклады отдельных признаков. Не «модель выбрала эту комбинацию», а «плюс столько-то за баланс чётных, минус столько-то за сумму чисел».
Плюсы: видно логику решения целиком. Модель перестаёт быть чёрным ящиком — вы буквально читаете её рассуждение. Минусы: отлично объясняет собственные решения и никак не помогает угадать тираж. Прозрачность рассуждения не делает рассуждение верным.
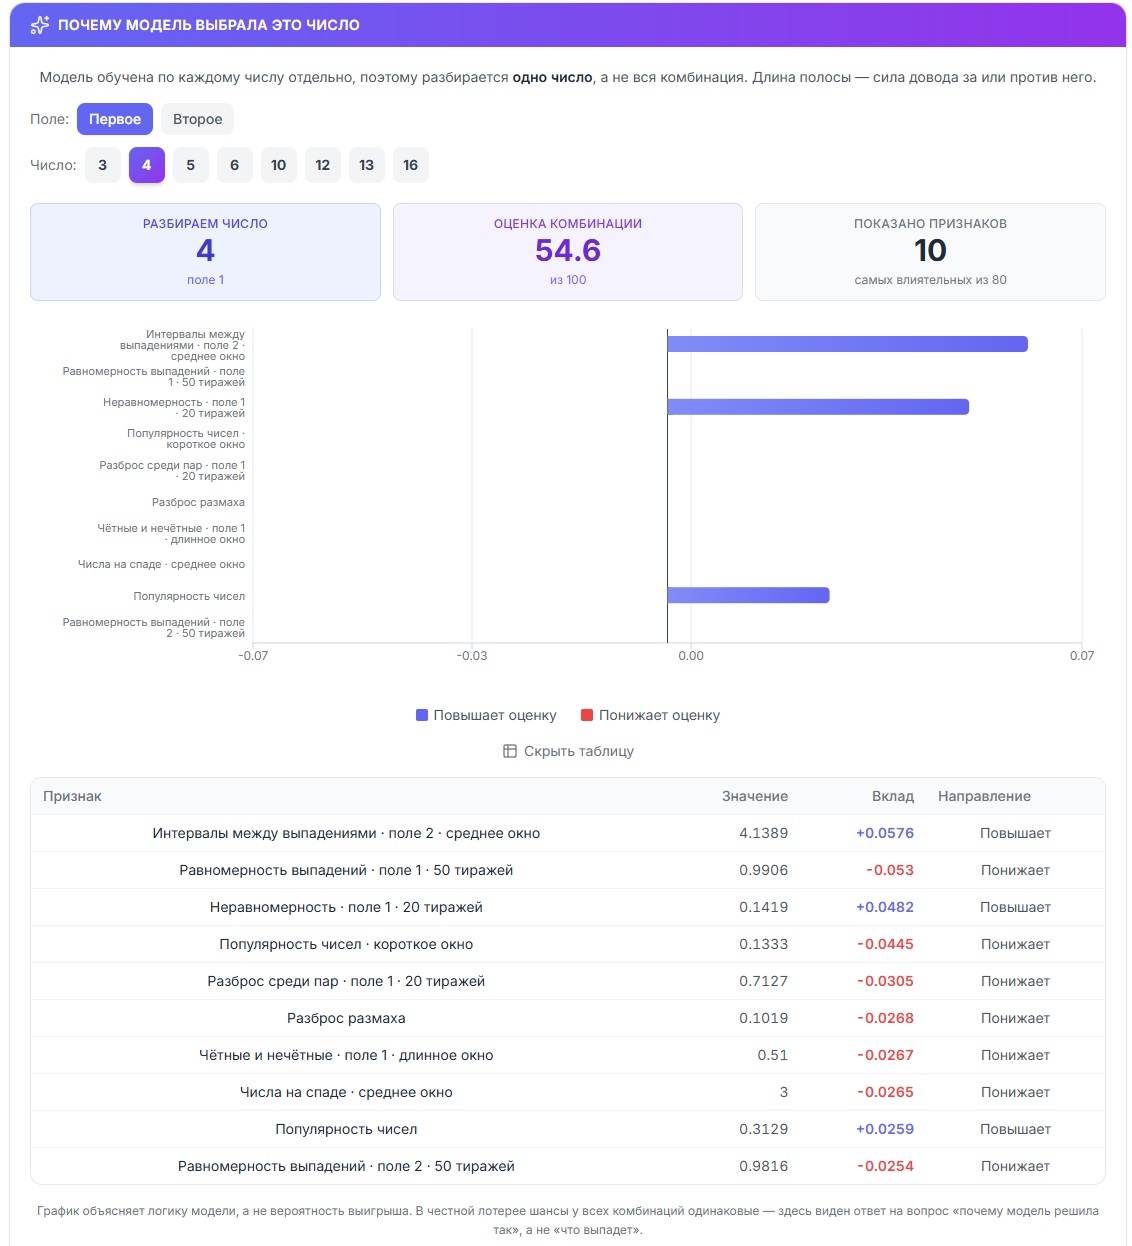
📷 Скриншот: график SHAP с вкладами признаков.
2. Генетические алгоритмы
Метод, подсмотренный у эволюции. Создаётся популяция комбинаций, каждая оценивается по заданному критерию, лучшие «скрещиваются», иногда происходят случайные мутации. Через несколько десятков поколений остаются самые приспособленные.
Звучит эффектно, и в задачах оптимизации это действительно мощный инструмент — там, где перебрать все варианты невозможно, а критерий качества понятен.
Плюсы: прекрасно решает настоящие задачи оптимизации — например, собрать комплект билетов с максимальным покрытием пула при ограниченном бюджете. Минусы: эволюция улучшает только то, что вы задали в критерии. Если критерий не связан с реальным шансом выигрыша — а он не связан, — то и оптимизация происходит впустую. Красивый процесс, аккуратно идущий в никуда.
3. Обучение с подкреплением
Агент играет в лотерею много тысяч раз, получает награду за выигрыши и штраф за стоимость билетов, и постепенно нащупывает стратегию, которая приносит больше награды. Ровно так же учат играть в шахматы и водить автомобиль.
Плюсы: отлично показывает границы метода на практике. Агент честно ищет закономерность — и не находит, потому что её нет. Это лучшая наглядная демонстрация того, что лотерея случайна. Минусы: обучение с подкреплением требует среды, где действия влияют на результат. В лотерее выбор чисел на результат не влияет никак, поэтому агенту нечему учиться. Высокие показатели на обучающих данных здесь означают только переобучение.
4. Временные ряды (ARIMA и сезонность)
Классика прогнозирования: методы, которыми предсказывают спрос, нагрузку и погоду. Модель ищет в последовательности тренд, цикличность и повторяющиеся структуры, а затем продлевает найденное в будущее.
В лотерейном контексте применяется к производным величинам: как меняется сумма выпавших чисел, доля чётных, разброс внутри комбинации.
Плюсы: хорошо отвечает на вопрос, есть ли в данных цикличность вообще. Автоматический подбор параметров и тест на стационарность — серьёзная методическая база. Минусы: на честной лотерее модель уверенно приходит к выводу «прогнозировать нечего», и это правильный ответ. Найденная «сезонность» на коротком архиве почти всегда оказывается шумом — проверяется это только на данных, которых модель не видела.
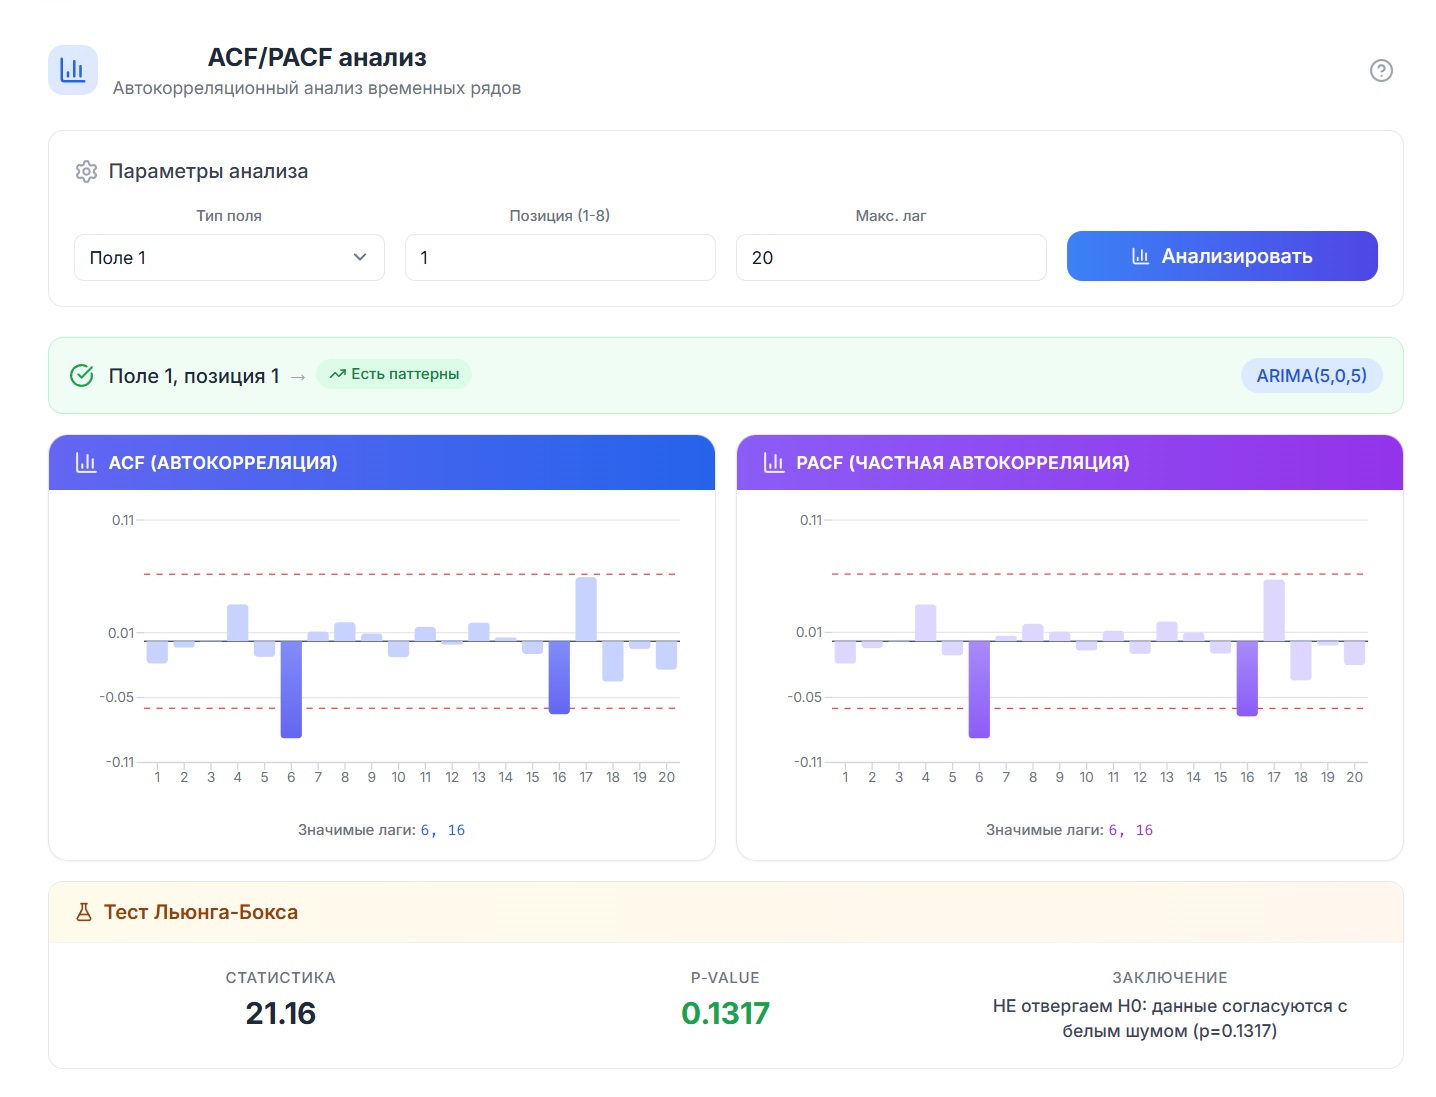
📷 Скриншот: график автокорреляции — видно отсутствие значимых пиков.
5. Байесовская модель
Самый математически аккуратный подход в списке. Вместо одной оценки вероятности модель хранит распределение вероятностей и обновляет его с каждым новым тиражом.
Практическая разница огромна. Обычная статистика скажет «это число выпадает в 5,2% случаев». Байесовская добавит: «с учётом объёма данных истинное значение лежит между 4,1% и 6,3%». Второе честнее — оно признаёт, чего мы не знаем.
Плюсы: правильно работает с неопределённостью, честно показывает доверительные интервалы, дообучается на новых тиражах без полного пересчёта. Именно этот метод нагляднее всех показывает, что наблюдаемые различия между числами укладываются в погрешность. Минусы: результат почти всегда сводится к «все числа равновероятны в пределах точности» — что и есть правда, но выглядит скучно рядом с яркими обещаниями конкурентов.
Что выбрать
По честному назначению каждого:
- Понять, как модель принимает решение — XGBoost с SHAP
- Собрать оптимальный комплект билетов под бюджет — генетические алгоритмы
- Убедиться, что закономерностей нет — обучение с подкреплением или временные ряды
- Увидеть настоящую точность оценок — байесовская модель
И общий вывод, ради которого стоило всё это перечислять.
Эти методы стоят в сервисе не потому, что они выигрывают лотерею. Они не выигрывают. Они стоят, потому что показывают её устройство с разных сторон — и все пять независимо приходят к одному и тому же ответу: система честная, предсказать нечего.
Пять разных математических аппаратов, сошедшихся в одном выводе, — это довольно веский аргумент. Куда более веский, чем чужие обещания системы угадывания.